
 English
AI Data Center không còn là Data Center truyền thống có gắn thêm GPU. Khi doanh nghiệp triển khai huấn luyện mô hình ngôn ngữ lớn, computer vision, phân tích dữ liệu thời gian thực hoặc AI inference quy mô lớn, hiệu năng của toàn hệ thống phụ thuộc rất lớn vào năng lực kết nối giữa GPU, storage và compute node.
Một cụm GPU có thể rất mạnh trên giấy tờ nhưng vẫn đạt hiệu suất thấp nếu mạng bị mất gói, tắc nghẽn hoặc mất cân bằng tải. Với AI workload phân tán, mỗi mili giây chờ đồng bộ dữ liệu đều có thể kéo dài thời gian huấn luyện và làm gia tăng chi phí vận hành.
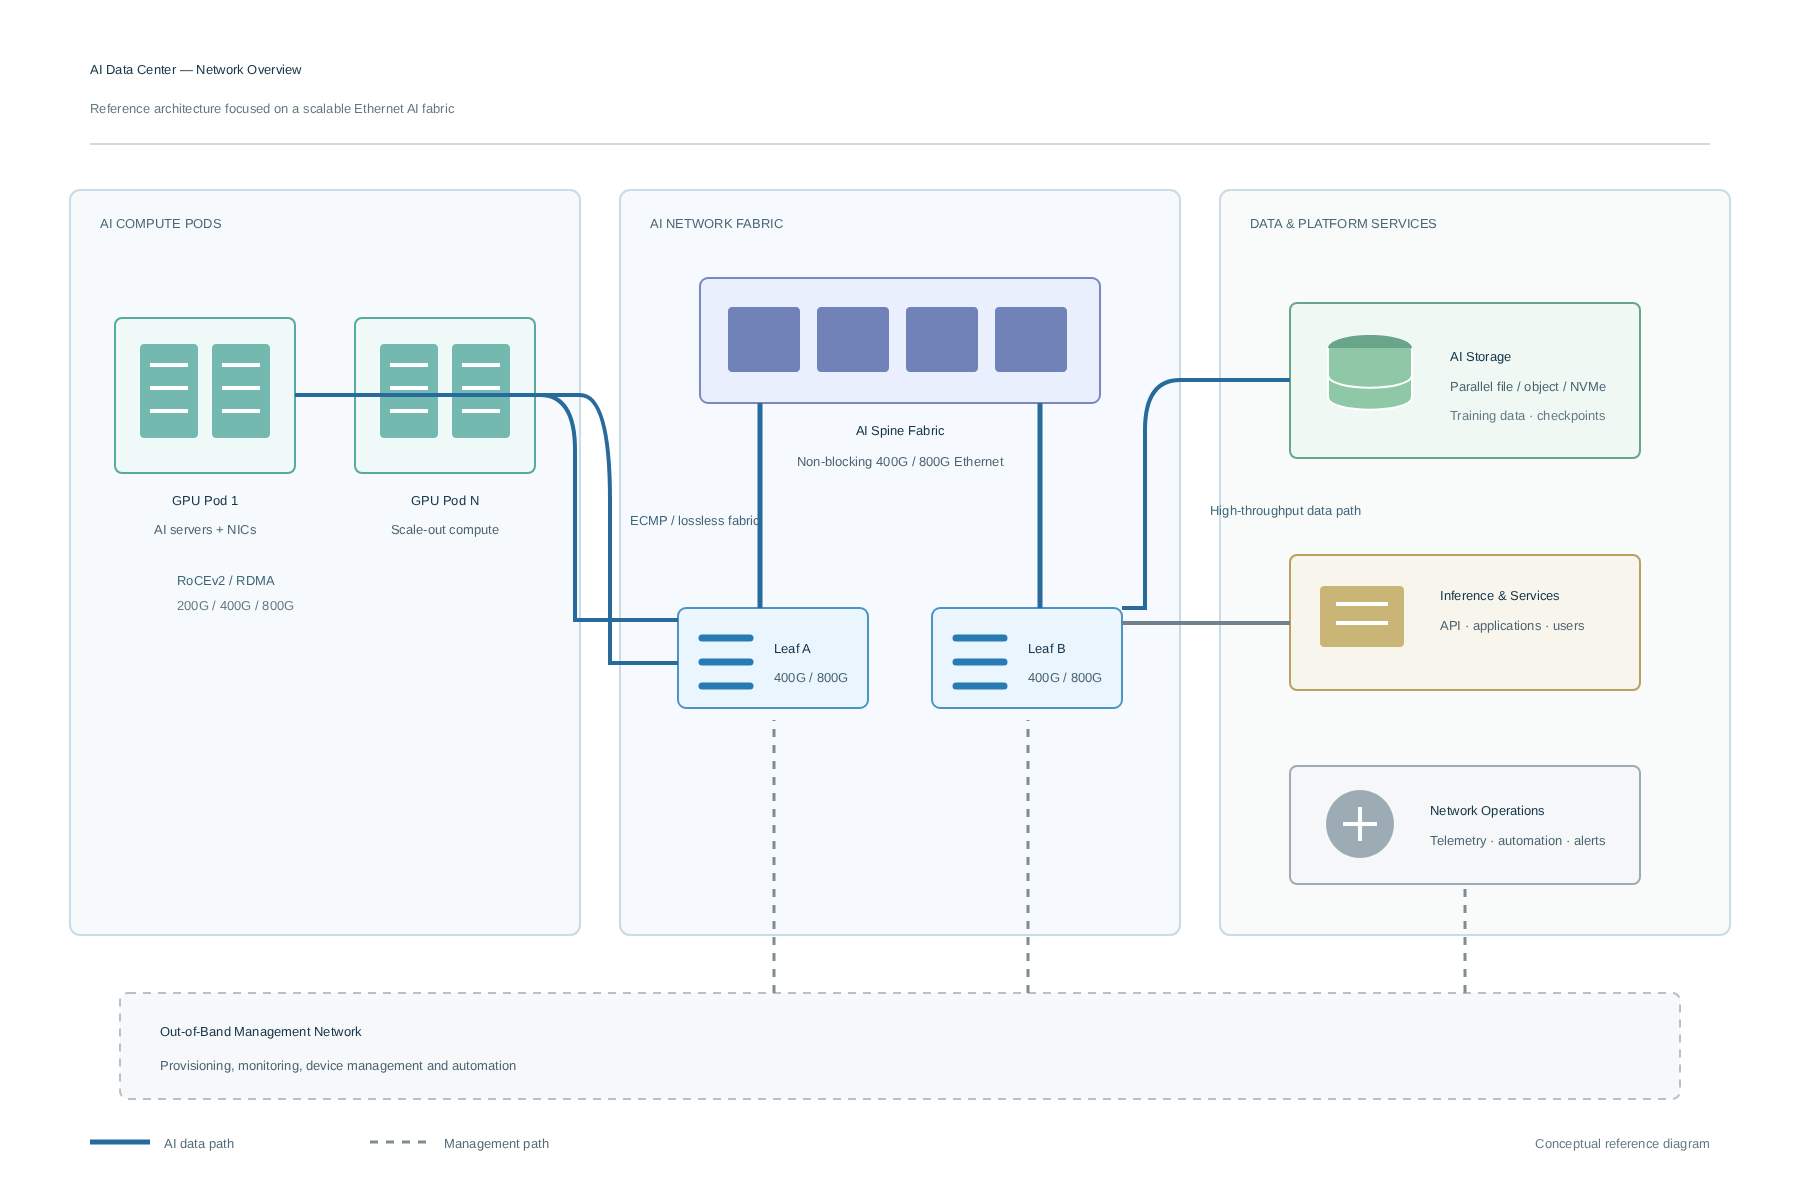
Bài viết này phân tích cách thiết kế mạng AI Data Center 400G/800G trên nền Ethernet, các nguyên tắc vận hành RoCEv2 lossless và vị trí của Arista Etherlink trong kiến trúc AI fabric hiện đại.
AI Data Center khác gì với Data Center truyền thống?
Data Center truyền thống thường phục vụ các ứng dụng client-server, web, cơ sở dữ liệu, ảo hóa và lưu lượng north-south — tức lưu lượng đi từ người dùng vào ứng dụng hoặc từ ứng dụng ra Internet.
AI Data Center có đặc tính khác biệt: phần lớn lưu lượng nằm ở hướng east-west, tức trao đổi ngang giữa các GPU server, storage node và compute node trong cùng cụm.
Trong một phiên huấn luyện phân tán, mỗi GPU không chỉ xử lý dữ liệu độc lập. Các GPU cần liên tục trao đổi gradient, tham số mô hình hoặc tensor với nhau. Những cơ chế collective communication như all-reduce, all-gather hay reduce-scatter có thể tạo ra các đợt lưu lượng đồng thời, cường độ rất cao.
Do đó, kiến trúc mạng AI cần giải quyết đồng thời bốn yêu cầu:
- Băng thông lớn và có thể mở rộng: 400G, 800G và lộ trình lên tốc độ cao hơn.
- Độ trễ thấp, đặc biệt ở các đường đi giữa GPU với GPU.
- Hạn chế mất gói cho lưu lượng RDMA/RoCE.
- Quan sát được congestion, queueing và bất thường theo thời gian thực.
Đây là lý do network fabric trở thành một phần của kiến trúc tính toán AI, thay vì chỉ là lớp hạ tầng kết nối.
Vì sao cụm GPU thường bị “nghẽn” ở mạng?
GPU hiện đại xử lý song song với tốc độ rất cao. Nếu đường truyền không theo kịp, GPU phải chờ dữ liệu hoặc chờ các GPU khác hoàn thành bước đồng bộ. Hiện tượng này thường được gọi là straggler effect: chỉ một node hoặc một đường truyền chậm cũng có thể kéo chậm toàn bộ job AI.
Các nguyên nhân kỹ thuật phổ biến gồm:
| Vấn đề | Tác động tới AI workload |
| Oversubscription quá cao | Uplink không đủ băng thông khi nhiều GPU truyền đồng thời |
| Incast | Nhiều nguồn gửi vào một đích/queue, gây congestion tức thời |
| Packet loss | RoCE có thể suy giảm hiệu năng mạnh do cơ chế xử lý mất gói |
| ECMP hash không hiệu quả | Một số link quá tải trong khi link khác còn nhàn rỗi |
| PFC cấu hình thiếu kiểm soát | Có thể lan truyền pause frame và tạo head-of-line blocking |
| Thiếu telemetry | Khó xác định vị trí congestion, queue buildup hoặc link degradation |
Vì vậy, mục tiêu của AI fabric không đơn thuần là “có tốc độ 800G”. Mục tiêu là đảm bảo băng thông hữu dụng được phân bổ công bằng, độ trễ ổn định và lưu lượng RDMA vận hành tin cậy khi hệ thống tăng quy mô.
RoCEv2 và vì sao AI network cần lossless Ethernet?
RoCEv2 là phương thức triển khai Remote Direct Memory Access trên Ethernet/IP. RDMA cho phép một server truy cập trực tiếp vào bộ nhớ của server khác với ít can thiệp của CPU hơn, từ đó giảm độ trễ và nâng cao throughput cho các workload cần truyền dữ liệu tốc độ cao.
Đối với cụm AI, RoCEv2 thường được dùng để hỗ trợ giao tiếp giữa GPU, NIC, storage và các node tính toán. Tuy nhiên, RoCE cần kiến trúc mạng được thiết kế cẩn thận hơn Ethernet thông thường.
Ba thành phần thường được nhắc đến là:
- Priority Flow Control (PFC): tạo cơ chế tạm dừng theo từng priority khi xảy ra congestion, giúp hạn chế mất gói.
- Explicit Congestion Notification (ECN): đánh dấu gói tin khi queue bắt đầu tăng, cho phép endpoint giảm tốc độ truyền trước khi buffer bị tràn.
- DCQCN: cơ chế điều tiết tốc độ truyền cho RoCE, dựa trên tín hiệu congestion từ mạng.
Điểm cần lưu ý: “lossless” không có nghĩa là bật PFC trên toàn bộ hạ tầng. PFC chỉ nên được giới hạn cho traffic class cần thiết, với ngưỡng queue, ECN và QoS được thiết kế đồng bộ. Nếu triển khai thiếu kiểm soát, PFC có thể làm congestion lan rộng và ảnh hưởng tới các luồng lưu lượng không liên quan.
Theo Arista, các nền tảng AI Ethernet của hãng tích hợp các khả năng như DCQCN, PFC, ECN và cơ chế load balancing nhận biết RoCE để vận hành môi trường RoCEv2 lossless. Arista AI Networking
Kiến trúc leaf–spine: nền tảng cho AI fabric scale-out
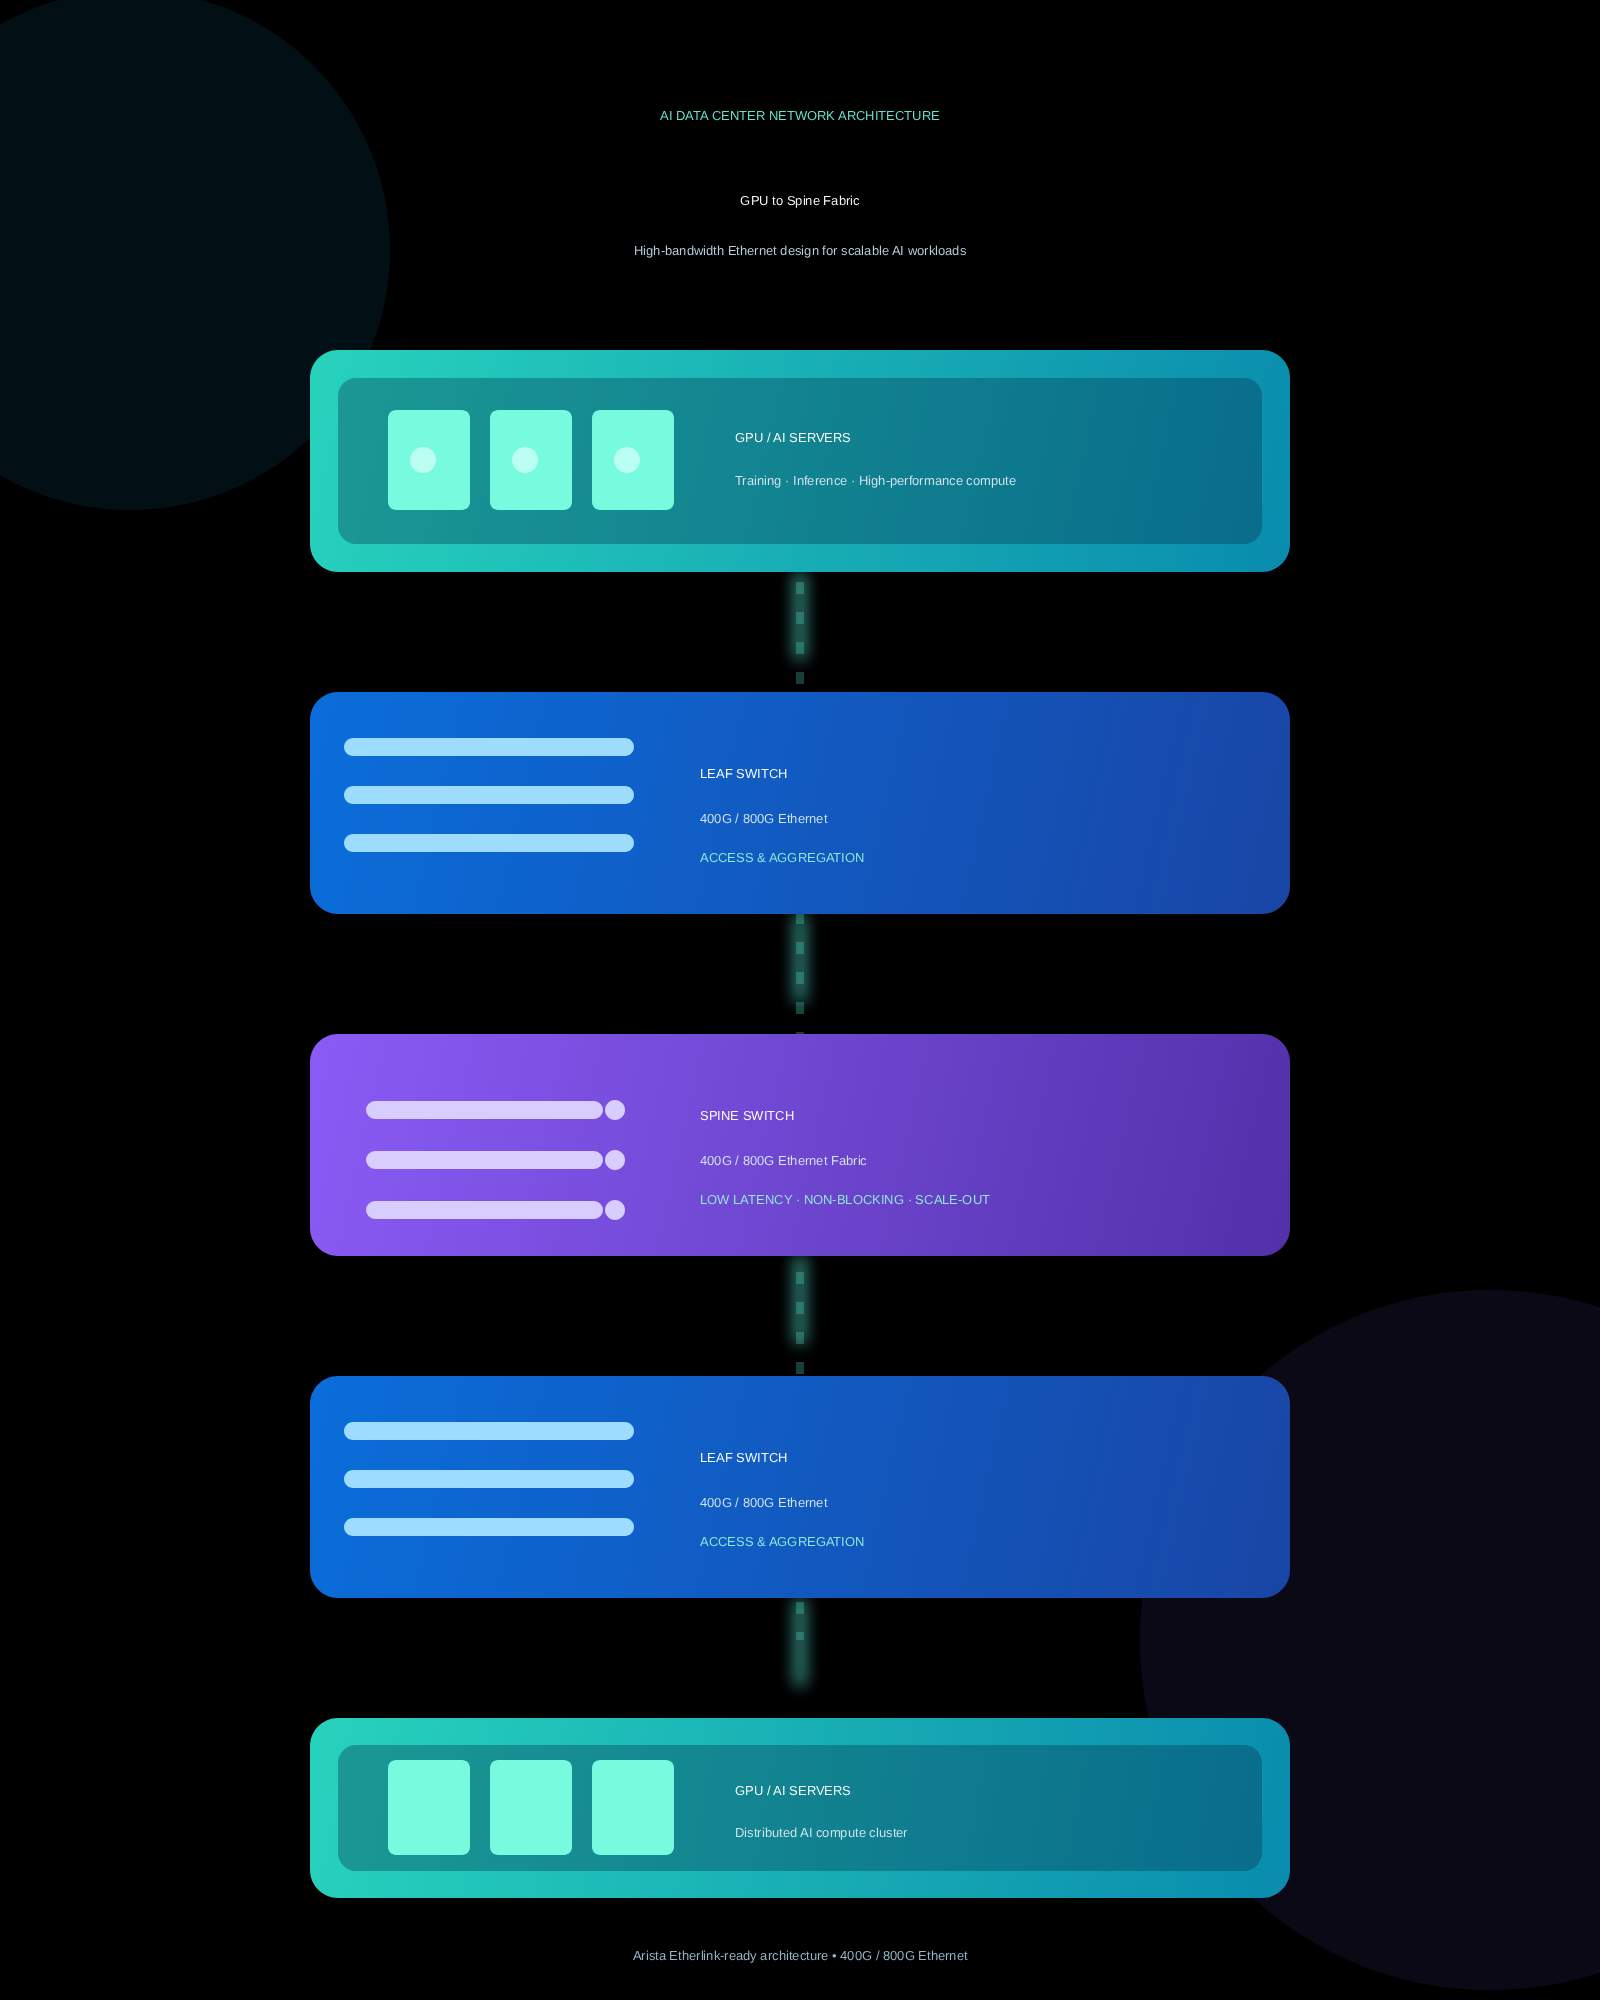 Kiến trúc phổ biến cho cụm GPU là Clos hoặc leaf–spine fabric
Mỗi GPU server kết nối vào leaf switch. Các leaf switch kết nối lên toàn bộ hoặc phần lớn spine switch. Nhờ đó, traffic từ một GPU đến GPU khác có số hop dự đoán được và có nhiều đường truyền song song.
Lợi ích của leaf–spine cho AI
- Độ trễ ổn định: các server ở leaf khác nhau thường đi qua số lượng hop tương đương.
- ECMP đa đường: lưu lượng có thể phân bố trên nhiều link leaf–spine.
- Mở rộng ngang: bổ sung leaf/spine khi tăng số lượng GPU.
- Giảm điểm nghẽn tập trung: không phụ thuộc vào một core switch duy nhất.
- Phù hợp workload east-west: tối ưu cho giao tiếp nội bộ giữa các node.
Với AI cluster nhỏ, kiến trúc có thể gồm hai leaf và hai spine. Khi quy mô tăng lên hàng trăm hoặc hàng nghìn GPU, hệ thống có thể phát triển thành fabric hai tầng, đa plane hoặc nhiều pod.
Sizing băng thông: không chỉ tính số cổng
Sai lầm phổ biến khi thiết kế AI Data Center là chọn switch theo số port hiện tại mà chưa tính nhu cầu băng thông thực tế, mô hình GPU, NIC và khả năng mở rộng.
Ví dụ, một server AI có 8 GPU có thể được trang bị nhiều NIC tốc độ 200G hoặc 400G. Nếu tổng băng thông downlink vào leaf lớn hơn uplink lên spine, hệ thống sẽ có oversubscription.
Công thức cơ bản:
Oversubscription ratio = Tổng băng thông downlink / Tổng băng thông uplink
Ví dụ:
- 32 cổng downlink 400G = 12,8 Tbps
- 32 cổng uplink 400G = 12,8 Tbps
- Oversubscription = 1:1
Tỷ lệ 1:1 phù hợp với AI training có cường độ giao tiếp cao, nhưng không phải mọi workload đều bắt buộc phải đạt 1:1. Với inference, front-end service hoặc workload hỗn hợp, kiến trúc có thể có mức oversubscription khác tùy theo traffic profile.
Điều quan trọng là phải sizing theo:
- Số GPU/server hiện tại và kế hoạch mở rộng.
- Số NIC trên mỗi server.
- Tốc độ NIC: 200G, 400G hay 800G.
- Lưu lượng giữa GPU với GPU, GPU với storage và GPU với front-end.
- Mức độ đồng thời của workload.
- Mục tiêu availability và khả năng chịu lỗi.
- Mô hình cáp DAC, AOC hay optical transceiver.
- Công suất, làm mát và không gian rack.
400G hay 800G: doanh nghiệp nên chọn gì?
400G vẫn là lựa chọn hợp lý cho nhiều AI cluster hiện nay, đặc biệt khi server/NIC, hệ thống cáp quang và ngân sách đang được chuẩn hóa theo tốc độ này. 800G phù hợp khi cần tăng port density, xây dựng fabric lớn hơn hoặc giảm số lượng tầng mạng.
| Tiêu chí | 400G | 800G |
| Phù hợp | Cluster AI đang triển khai hoặc mở rộng từng giai đoạn | AI factory, cloud, HPC và cluster GPU mật độ cao |
| Port density | Tốt | Cao hơn, giảm số lượng port/switch cần thiết |
| Khả năng breakout | Linh hoạt theo nền tảng và optics | Có thể breakout xuống 400G/200G/100G tùy thiết kế |
| Lộ trình mở rộng | Phù hợp đa số enterprise | Phù hợp đầu tư dài hạn và tăng trưởng nhanh |
| Yêu cầu cáp/quang | Dễ tiếp cận hơn trong nhiều môi trường | Cần đánh giá kỹ optics, công suất và nhiệt |
Arista 7060X6 là một ví dụ cho hướng tiếp cận này: dòng switch fixed-form-factor hỗ trợ nhiều tốc độ từ 50G đến 800G, với model có năng lực chuyển mạch đến 51,2 Tbps và tối đa 64 cổng 800G hoặc 128 cổng 400G. Thông số Arista 7060X6
Arista Etherlink giải quyết những bài toán nào?
Arista Etherlink là danh mục giải pháp Ethernet dành cho AI networking, được xây dựng trên Arista EOS và hướng tới hệ thống mở, tương thích với nhiều loại accelerator, NIC và storage.
Trong AI fabric, tính năng quan trọng không chỉ là tốc độ interface. Khả năng điều phối traffic, phản hồi congestion và cung cấp telemetry có vai trò quyết định với hiệu suất job AI.
Một số cơ chế kỹ thuật đáng chú ý gồm:
Dynamic Load Balancing và RDMA-aware load balancing
Lưu lượng AI thường có ít “flow” lớn và kéo dài, hay còn gọi là elephant flow. Nếu chỉ dùng hash ECMP truyền thống, nhiều flow lớn có thể vô tình cùng đi vào một đường link, trong khi các link khác chưa được khai thác hết.
Dynamic Load Balancing giúp đưa trạng thái tải thực tế của link vào quyết định phân phối traffic. Với AI/RDMA, cơ chế cân bằng tải cần hiểu đặc tính của queue pair và collective communication để giảm tail latency — độ trễ cao bất thường ở một phần nhỏ flow nhưng có thể làm chậm toàn bộ job.
Arista mô tả các khả năng DLB, Cluster Load Balancing và cơ chế RDMA-aware load balancing trong EOS nhằm tối ưu placement của collective communication và giảm tail latency. Arista: Powering All Ethernet AI Networking
Congestion management: ECN, PFC, DCQCN
Một fabric AI tốt cần phát hiện congestion sớm, gửi tín hiệu về endpoint và phản ứng trước khi queue bị tràn. ECN, PFC và DCQCN phải được thiết kế như một hệ thống thống nhất, không phải ba tính năng bật độc lập.
Arista Etherlink công bố hỗ trợ các cơ chế congestion control, PFC-aware DLB, PFC-aware ECN, packet spraying và packet trimming trên những nền tảng AI mới. Arista 7060XE7 Datasheet
Packet spraying và multi-plane fabric
Khi cluster tăng lên rất lớn, multi-plane topology có thể giúp mở rộng bandwidth và giảm ảnh hưởng của lỗi trên một phần fabric. Packet spraying phân phối packet hoặc traffic theo nhiều path để tận dụng tốt hơn băng thông sẵn có.
Tuy nhiên, kỹ thuật này cần xử lý nghiêm túc vấn đề packet reordering và tương thích endpoint. Multipath Reliable Connection (MRC) là một hướng tiếp cận tiêu chuẩn hóa để xây dựng multi-plane Ethernet scale-out fabric, thay vì phụ thuộc vào triển khai khép kín của một nhà cung cấp. Tài liệu Arista về multi-plane fabric với MRC
Khi nào nên chọn Arista 7060X6, 7800R4 hay 7700R4?
| Nền tảng | Phù hợp nhất khi | Vai trò điển hình |
| Arista 7060X6 | Cần fixed switch mật độ cao, linh hoạt tốc độ 400G/800G | AI leaf hoặc spine cho pod/cluster |
| Arista 7800R4 | Cần chassis modular, spine lớn, tăng trưởng dài hạn | AI spine, Data Center core, routing/storage quy mô lớn |
| Arista 7700R4 DES | Cần AI fabric cực lớn và thiết kế distributed scale-out | Hệ thống accelerator quy mô rất lớn |
Arista 7800R4 hỗ trợ đến 460 Tbps switching capacity trong một chassis, tương ứng tối đa 576 cổng 800G hoặc 1.152 cổng 400G ở cấu hình cao nhất. Nền tảng dùng kiến trúc VOQ và deep buffering để xử lý traffic có tính burst, incast và mismatch tốc độ. Arista 7800R4 Series
Với các triển khai cực lớn, Arista định vị 7700R4 Distributed Etherlink Switch cho kiến trúc phân tán, có khả năng điều phối end-to-end và traffic spraying trên fabric rất lớn. Đây không phải lựa chọn mặc định cho mọi doanh nghiệp; quyết định cần dựa trên số accelerator, topology, ngân sách, mô hình vận hành và lộ trình mở rộng thực tế. Arista 7700R4 Distributed Etherlink Switch
Vận hành AI fabric: telemetry không phải tính năng phụ
Khi AI job chậm, đội ngũ vận hành cần trả lời nhanh các câu hỏi:
- GPU nào đang chờ network?
- Link hoặc queue nào đang congested?
- PFC có bị kích hoạt quá mức không?
- ECN marking xuất hiện ở đâu và vào thời điểm nào?
- Có link nào mất cân bằng tải hoặc lỗi optics không?
- Hiệu năng giảm do mạng, storage hay compute?
Đây là lúc telemetry trở thành yếu tố vận hành cốt lõi. Arista EOS hỗ trợ streaming state và telemetry, API lập trình được, sFlow cùng các công cụ quan sát như LANZ để hỗ trợ phân tích độ trễ/queueing. EOS cũng hỗ trợ tự động hóa thông qua eAPI, OpenConfig, Python, Ansible và các công cụ DevOps. Tổng quan Arista EOS
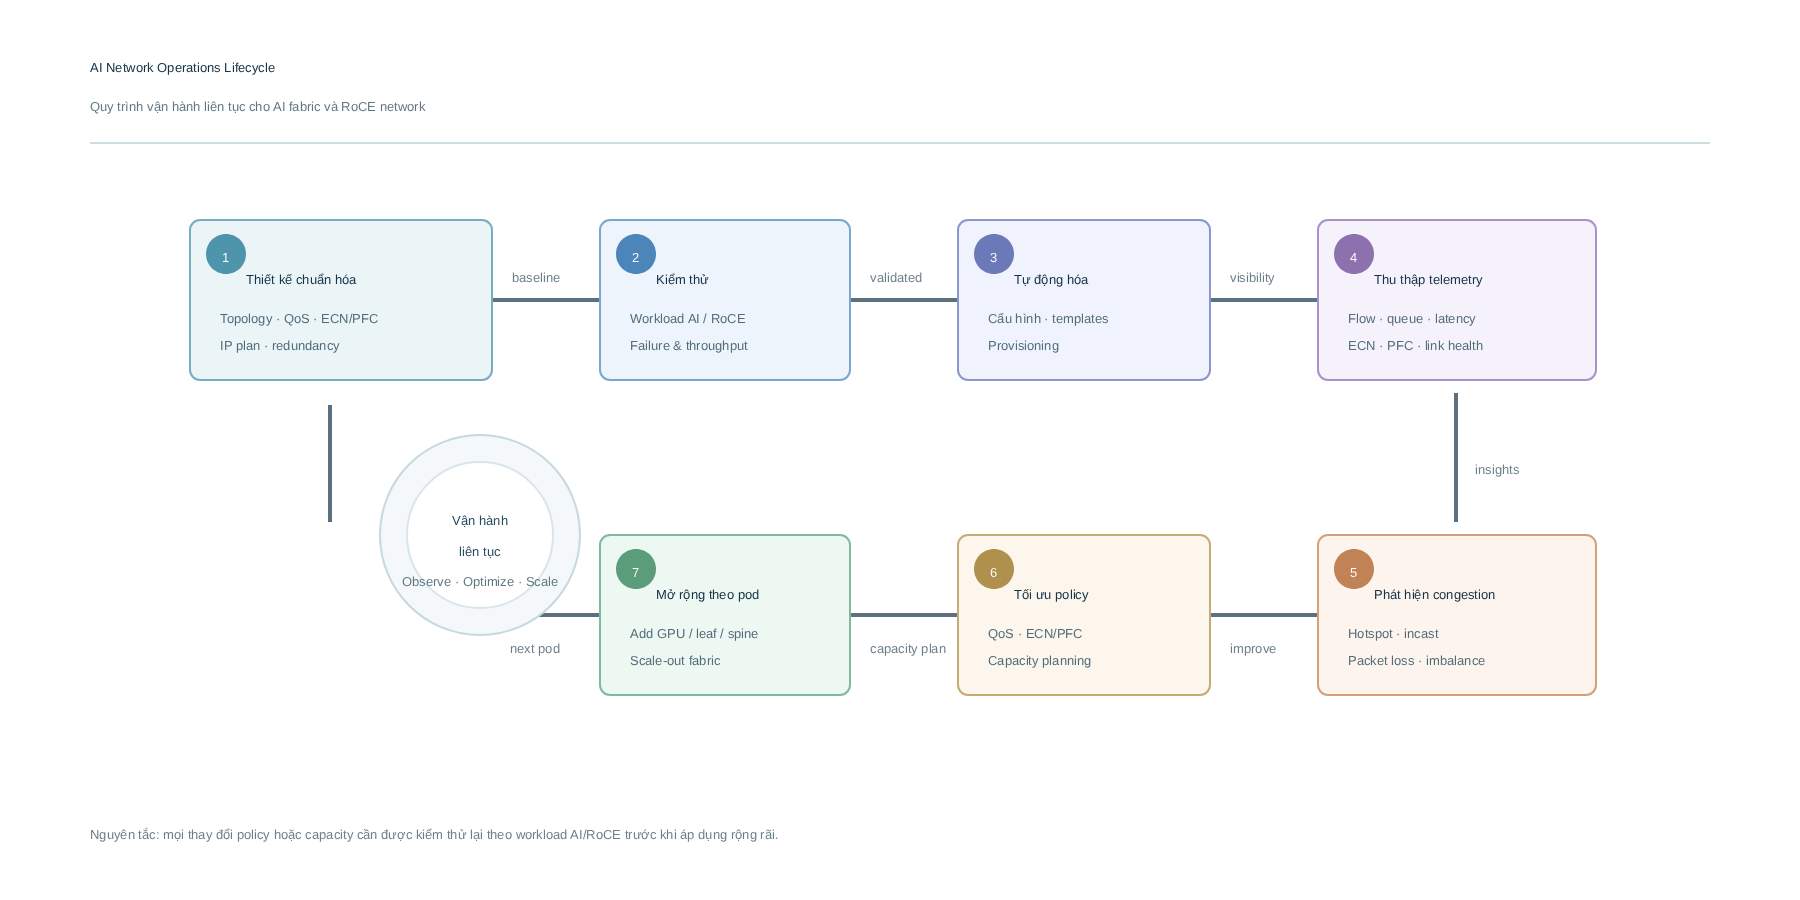
Một AI fabric hiện đại nên được vận hành theo vòng lặp:
 Thiết kế chuẩn hóa
Checklist thiết kế AI Data Center 400G/800G
Trước khi chọn thiết bị, doanh nghiệp nên xác định rõ:
- Workload là AI training, inference, HPC hay hỗn hợp?
- Cụm có bao nhiêu GPU hiện tại và mục tiêu sau 24–36 tháng?
- Server có bao nhiêu NIC và mỗi NIC chạy ở tốc độ nào?
- Có yêu cầu 1:1 non-blocking hay chấp nhận oversubscription?
- Có cần RoCEv2 lossless không?
- Chính sách ECN, PFC, QoS và DCQCN sẽ được kiểm thử thế nào?
- Mô hình redundancy cho switch, uplink, nguồn điện và optics là gì?
- Có yêu cầu multi-tenancy, segmentation, VXLAN hoặc encryption không?
- Hệ thống giám sát có thể thu thập queue latency, congestion và link health không?
- Team vận hành có cần tự động hóa bằng Ansible, API hoặc GitOps không?